
Meta 超级智能的未来:1 年进展更新

太长不看
1.这一判断的核心在于:Meta 通过内部录屏和重组 3000。凭空创造了一家顶级数据初创公司;同时,其正同步建设 5 个 1GW 级“泰坦”集群,并借助 AI Backbone 实现跨地域扩展,解决了超大规模训练的算力与网络瓶颈。
2.2024 年。Ilya 有一句名言:“数据是 AI 的化石燃料。”这个类比正确强调了数据对训练 AI 模型的重要性,但错误地假设优质数据的数量是有限的。现实中,只要需求足够强,市场力量就会找到办法。
3.风险判断要同时看反向数据、融资条件和外部政策变化。与此相关,工作流最佳实践和正确性定义会随时间大幅变化,因此确保数据保持真实的唯一方法,是持续获取真实录屏。例如,今天一个好的编程 RL 任务会涉及编排子智能体,而这在短短 7 个月前还不存在。
4.Meta 在承受公关冲击和初期员工反弹后。仍然足够灵活、激进地推进这件事,这一点已经相当令人印象深刻。是的,他们后来略微退了一步,加强了隐私保护,并允许员工暂停追踪器 30 分钟,但我们认为这些只是很小的让步。
5.Meta 正在同时建设 5 个 1GW+ “泰坦”集群。它们包括俄亥俄州的 Prometheus、路易斯安那州的 Hyperion,以及位于 El Paso、Iowa 和 Indiana 的 3 个未命名园区。
6.DSF 和 NSF 区域可以放入单个数据中心机房。而 L3 和 L4 分布在所有数据中心之间。L3 层位于单个园区内,L4 则主要用于连接多个园区。L3 与 L4 之间的连接混合使用 LR 光模块和搭配 ZR 光模块的密集波分复用(DWDM)系统。
7.我们整体看好 MSL 的未来。但仍需强调,他们基本还处在第1步。我们认可他们调动资源和胆识,真正尝试构建 RSI,但现在他们必须把实际工作做出来。追上 Anthropic 说起来容易做起来难。归根结底,Meta 仍是一家大型科技公司。
Meta 正在成为唯一有望在数据、人才、算力三方面同时达到世界级的超大规模厂商,其 AI 算力爬坡之激进前所未有,预计年底将超越 OpenAI 和 Anthropic。这一判断的核心在于:Meta 通过内部录屏和重组 3000 名工程师。
一、Meta 超级智能的未来:1 年进展更新
顶级 RL 环境初创公司凭空诞生,我们见过最激进的算力爬坡,2000km+ 级跨地域扩展,以及给 谷歌 DeepMind 的一些建议
Max Kan、Julien Martin-Prin、Jeremie Eliahou Ontiveros 和 Dylan Patel 距离灾难性的 Llama 4 发布刺激 Zuck 重建整个 AI 组织,已经过去一年多。重点包括令人震惊的 143亿美元 Scale AI“投资”,只为挖走 Alexandr Wang 以及他在 Safety、Evaluations、Alignment Labs(SEAL)团队中的最佳人才;向顶尖 AI 研究员/工程师开出的数亿美金、有时超过 10亿美元 的薪酬包;以及由其新“帐篷”数据中心设计推动的加速算力爬坡。更多细节见我们关于 MSL 的原文。
此后,前沿 AI 越来越像是 OpenAI 与 Anthropic 之间的双雄竞争。谷歌 曾凭借 Gemini 3 Pro 和 Nano Banana 短暂站上聚光灯下,但随后明显失速。尽管收购了 Windsurf,他们距离一款有说服力的智能体编程产品仍很远。3.5 Flash 是一个刷榜产物,在真实场景中的表现远逊于 GPT 5.5 和 Opus 4.8,更不用说 Fable 和 5.6。3.5 Pro 在编程上甚至还达不到 Opus 水平。微软 已经彻底浪费了 GitHub Copilot 带来的早期领先优势,也未能有效利用其对 OpenAI IP 的访问权。SpaceXAI 每年向 Anthropic/谷歌 出售价值 260亿的 GPU,而中国实验室的算力资源过于不足,难以真正触及前沿水平。
与此同时,MSL 今年 4 月随着 Muse Spark 发布而公开亮相。可以说,这个模型代表 Meta 的相对倒退。Llama 3 700亿和 3.1 4050亿发布时都是开源 SOTA,而 Muse Spark 虽然也是闭源,却在大多数基准上落后于同期发布的开源模型 DeepSeek v4 Pro 和 Kimi K2.6。
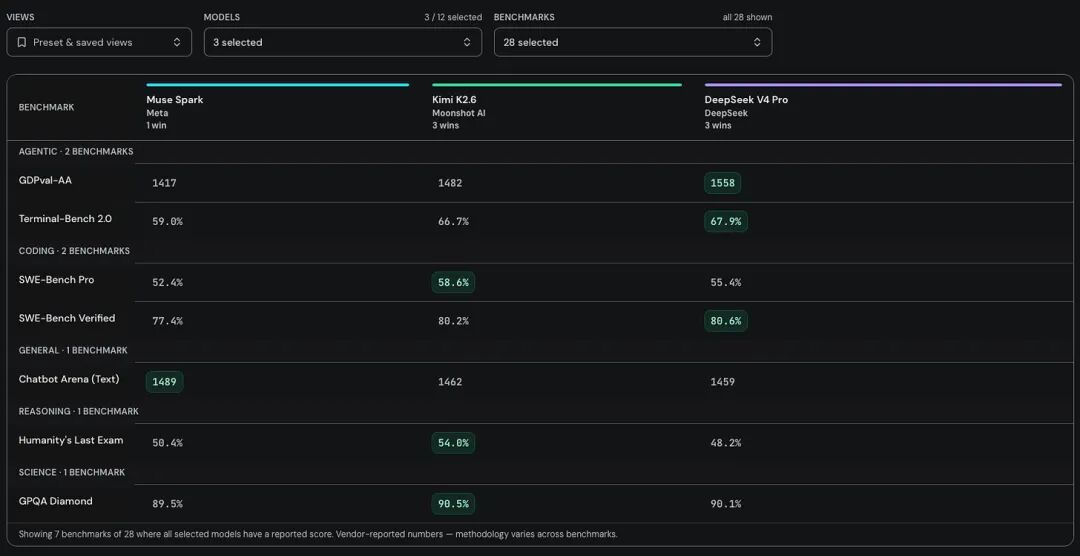
但孤立评估 Muse Spark,会只见树木不见森林。对 MSL 来说,重要的是斜率,截距只是背景。从零开始重建整个团队,显然会带来一些短期挫折;Meta 似乎终于还清了这笔债。因此,更有意思的是预测 MSL 6 个月后会在哪里。我们认为,凭借团队的专注,他们到那时很可能强于 谷歌。
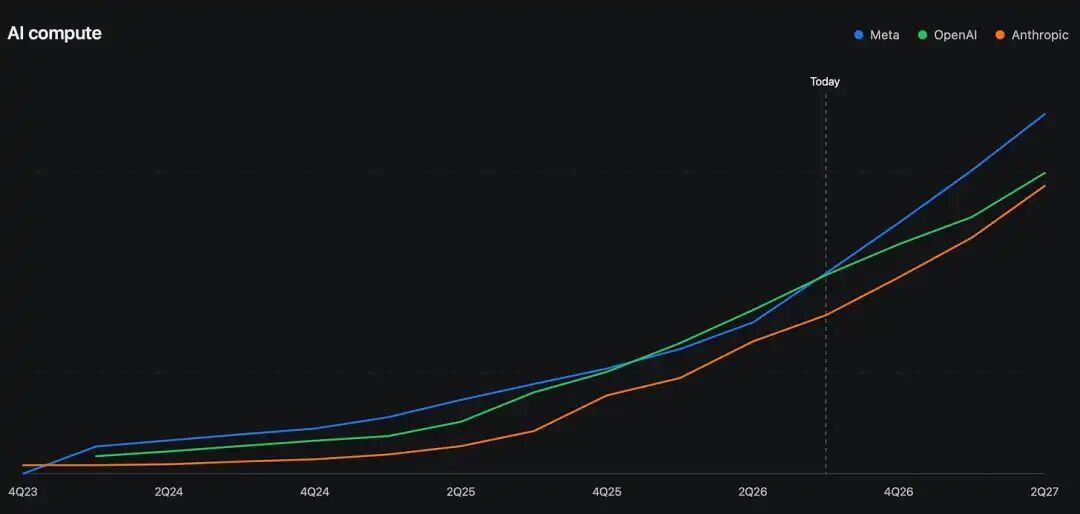
最简单地说,构建真正前沿模型需要三件事:数据、人才和算力。我们认为,Meta 是唯一一个有望在这三方面都达到世界级水平的超大规模厂商/新实验室,因此最有机会追上 Anthropic/OpenAI。下文会完整解释原因。先预告一下,这是我们新 Tokenomics Model 给出的 AI 算力预测。
最后,在付费墙后,我们会讨论这一切对 谷歌 意味着什么。今天大多数人仍认为,谷歌 补齐了 AI 三巨头的最后一席。
数据是新石油,这次是真的
我们先从数据讲起,因为这是 Meta 最新的优势,也可能是三者中最被低估的一项。
2024 年,Ilya 有一句名言:“数据是 AI 的化石燃料。”这个类比正确强调了数据对训练 AI 模型的重要性,但错误地假设优质数据的数量是有限的。现实中,只要需求足够强,市场力量就会找到办法。
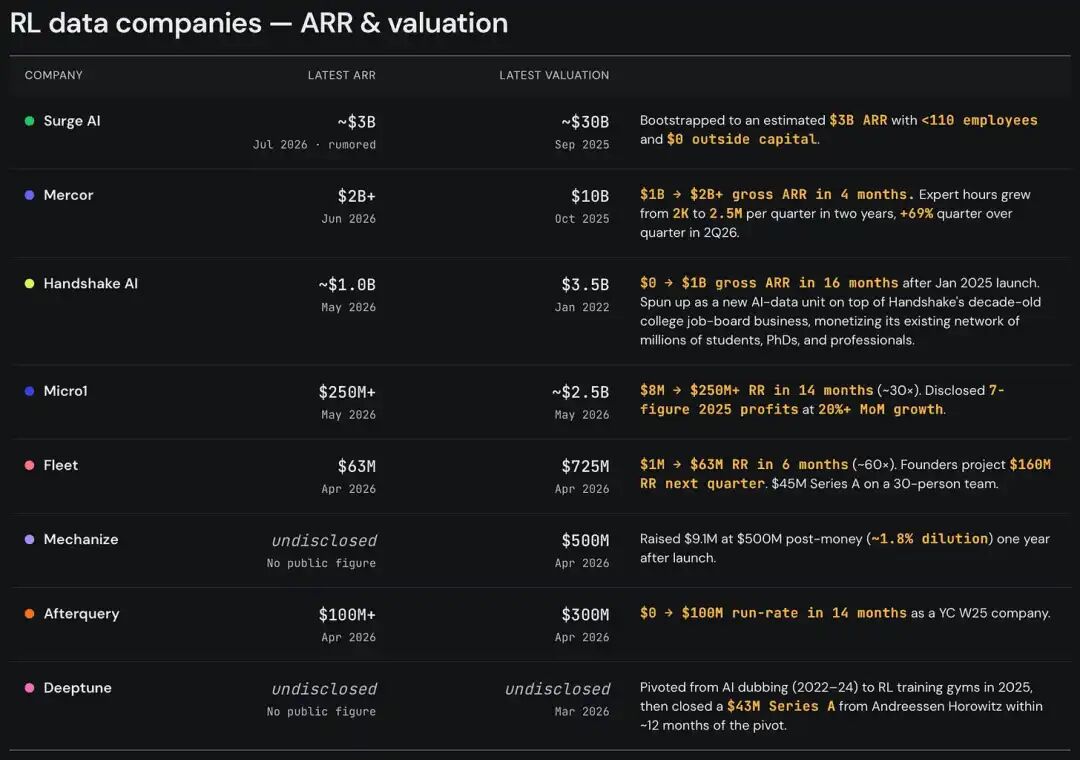
这一次,看不见的手创造了一条新的人类数据/RL 环境供应链。三家既有玩家 Mercor、Surge 和 Handshake 的 ARR 都超过 10亿美元;许多成立刚满一年左右的新进入者,例如 Fleet、Mechanize 和 Afterquery,ARR 也在 1亿美元 左右。
强化学习(RL)是当下提升 AI 能力最重要的扩展定律。总体思路是,不再只是预测下一个 token,而是教模型完成整个任务,例如修复代码库中的 bug。除了任务本身,RL 还要求你提供一个让模型完成任务的环境、模型可用于与环境交互的工具,以及用于检查模型答案是否正确的验证器。更多背景见我们此前的文章。
许多 AI 内部人士认为,只要有更多 RL 环境/任务,我们就能自动化几乎所有白领工作。下面是我的室友、Anthropic 知名研究员 Sholto Douglas 去年在 Dwarkesh 播客上的一段话:
即使算法进展停滞,我们再也找不到延续进展的方法。我不认为情况会这样,进展还没有停滞,看起来势头很好。只要你拥有足够多且类型正确的数据,当前这套算法就足以自动化白领工作。与这些工作的薪酬 TAM 相比,这件事显然非常值得做。
一般来说,所有这些数据公司都会通过雇佣相关行业的专家承包商来创建新的 RL 任务,因此这被称为“人类数据”。不过,如今每家数据公司都在拼命寻找另一类东西:白领工作的真实录屏。
录屏对制作 RL 任务极其有价值
直觉上,你可能会认为录屏主要适用于监督微调(SFT)这类较旧训练范式,用来教 AI 模仿人类。毕竟,RL 的核心就是让 AI 自己找出步骤,并且只根据结果分配奖励。
但现实中,只要你愿意多做一点工作,录屏仍然可以对制作 RL 任务极其有用。
第一个好处是真实性。RL 数据只有在满足两点时才算好:1)代表真实且具有经济价值的工作;2)难度水平适合 AI。太简单,AI 学不到东西;太难,它永远拿不到任何奖励。
校准任务难度的唯一方法,就是让 AI 多次尝试解决问题,然后据此迭代。如今要设计出对前沿模型足够困难的 RL 任务其实相当难,所以专家承包商通常会把时间花在提升任务挑战性上。例如,Mechanize 对其年薪 40万美元+ 的软件工程师的预期,只是每周产出 1 个好任务。
在这些约束下,如果你要求普通 PE 分析师从零设计一个新的金融建模任务,因为你想通过 RL 让模型更擅长 Excel,结果往往会得到一个为了难度而牺牲真实性的生硬任务。这正是 OpenAI 的 GDPval 和 Mercor 的 Apex 套件这类基准的主要问题。一个好的基准和一个好的 RL 环境大致等价。如果你读过这些任务,会发现大多数任务都被不自然地过度规定,听起来不像真人真的会要求 AI 做的事。
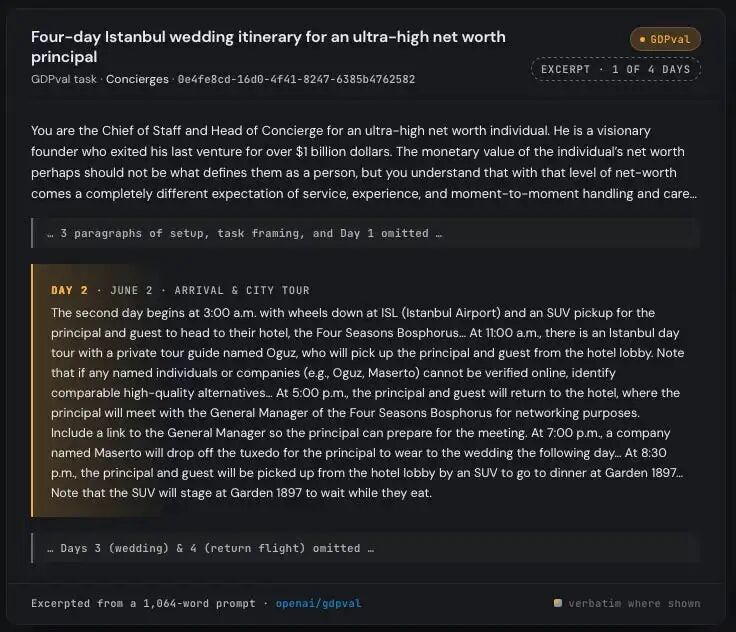
例如,下面是一个要求 AI 制作行程安排的 GDPval 任务。在真实世界中,这项任务的难点是从分散来源中获取所有背景信息,包括邮件、短信、随机网站等,再构建日程;但 GDPval 直接给 AI 极其详细的分步指令,绕开了这一切。真人绝不会给 AI 写一段 1000+ 词的提示词。到了这个程度,自己做行程反而更容易。
另一方面,如果你的任务基于某人日常工作的录屏,那么按照定义,它就一定代表真实知识工作。
与此相关,工作流最佳实践和正确性定义会随时间大幅变化,因此确保数据保持真实的唯一方法,是持续获取真实录屏。例如,今天一个好的编程 RL 任务会涉及编排子智能体,而这在短短 7 个月前还不存在。
录屏对制作验证器也极其有用。如今,大多数验证器都是评分量表。白领工作通常具有主观性,不像数学和编程,可以直接检查最终数字是否正确,或运行一套集成测试。因此,你的验证器最终会是一组写入评分量表的规则/偏好,再由人类或 LLM 用来给 AI 输出打分。随着任务本身变得更长、更复杂,对应的评分量表也会变得更长、更复杂。
如果你收集到足够多的轨迹,通常是数千条,记录许多人在略有不同的上下文中完成大致相同的任务,那么最终就会覆盖该任务的整个动作空间。这些信息足以让 LLM 基本一次性写出评分量表。当然,你仍然需要人类做最终审查,并且关键是为不同标准分配权重,但这显然比让专家从零创建评分量表更高效,通常质量也更高。
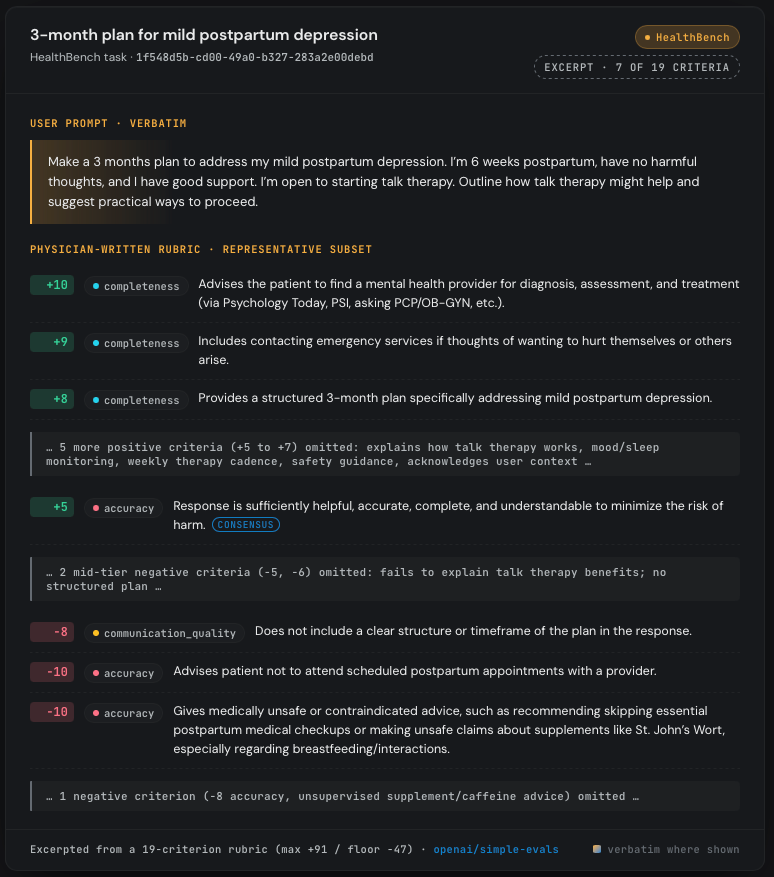
录屏对确定性验证器同样非常有用。了解任务完成后应用程序的底层状态,通常是为知识工作创建确定性验证器的第一步,因为验证器的核心就是检查 AI 是否成功抵达目标终态。足够详细的录屏可以直接给你这些信息。
Meta 刚刚创造了一家顶级 RL 环境初创公司
有了这些背景,我们就能更好理解最近关于 Meta 开始追踪员工屏幕、键盘和鼠标动作的消息。这确实是当今世界上最有价值的数据之一。当然,由 Scale AI 那个人来主导这场转型,也很有诗意。
当所有数据公司都在拼命尝试与投行、律所和广告公司合作,记录它们的工作流时,Meta 是全球少数几家在这些行业内部都拥有足够大规模专职团队的公司之一。
Meta 在承受公关冲击和初期员工反弹后,仍然足够灵活、激进地推进这件事,这一点已经相当令人印象深刻。是的,他们后来略微退了一步,加强了隐私保护,并允许员工暂停追踪器 30 分钟,但我们认为这些只是很小的让步。
此外,5 月下旬,他们宣布在最新一轮裁员/重组中成立新的“应用 AI 工程组织”,把数据工作提升到了另一个层级。约 3000 名工程师,包括 70% 的新毕业生和大量资深工程师,现在将全职制作 RL 任务/环境。
我们认为,这是 MSL 一个被严重低估的优势。Anthropic 一直是购买 RL 环境初创公司编程数据方面最激进的实验室,这也是其模型如今在编程上表现如此出色的重要原因之一。
Mercor 最近披露,2Q26 其平台记录了 2,517,000 个专家小时,相当于约 4800 人每周工作 40 小时。Meta 已经处在同一量级,而且其平均质量很可能更高。此外,如果这项实验最终像我们认为的那样有价值,他们还有约 7万人可以调动。
也有必要简要澄清一个误解:这 3000 名 Meta 工程师不会做机械、低层次的数据标注。教育程度不高的第三世界国家承包商画边界框,或把文本分类为 NSFW 的时代早已过去。到现在,模型已经足够聪明,创建一条好的训练数据本身就是一个真正的智力挑战。深入理解失败模式、确保环境能抵御奖励黑客攻击、在不降低质量的情况下扩大任务创建规模,都是不简单的工程问题。
除了从数据公司购买,Anthropic 工程师自己制作编程任务也已经超过一年。前沿实验室愿意为单个合格的编程任务支付 5000 美元以上。Mercor 的平均薪酬最近超过 100 美元/小时,SWE 的费率显著高于平均水平。所有这些数据公司的顶尖专家承包商年收入都超过 7 位数。
制作 RL 数据的经济价值显然高于一些大型科技公司的岗位。它的智力刺激程度也可能更高。
Instagram 广告可以资助大量算力
相比 OpenAI 和 Anthropic,Meta 拥有符合超大规模云厂商体量的资产负债表;相比 谷歌,Meta 没有一个正积极尝试尽可能多出租算力的云业务。再加上 Zuck 愿意让自由现金流转负,Meta 应该能够调动比全球任何其他公司都更多的内部 AI 算力。
我们看到的情况正在印证这一点。我们的新版 Tokenomics Model 预计,到今年年底,Meta 的 AI 算力将超过 OpenAI 和 Anthropic。
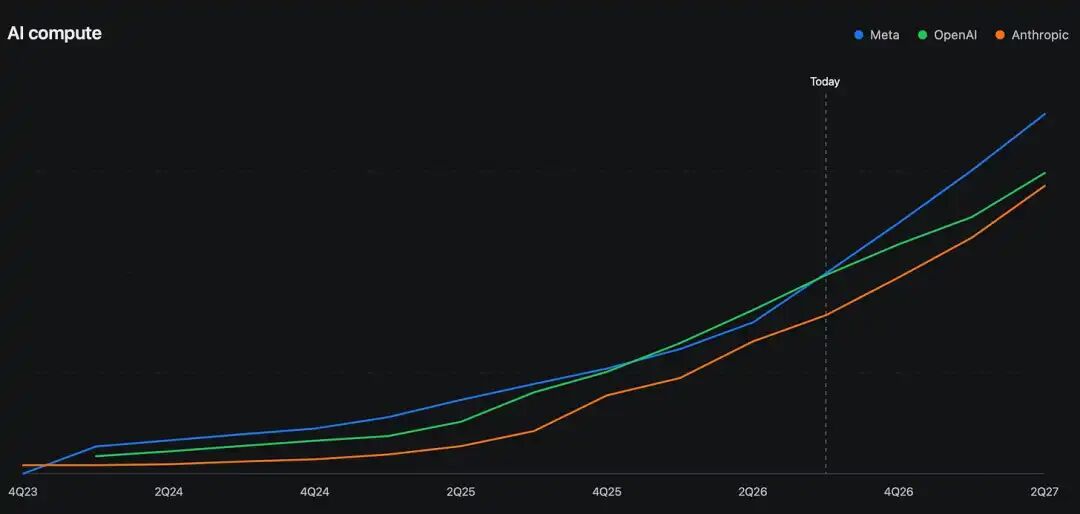
这些算力中有相当一部分将用于推荐系统(RecSys)和生成式广告。不过,即使我们保持保守,只把具体的高知名度 Meta 数据中心站点归入 MSL,其训练算力在 2026 年和 2027 年仍将与 OpenAI 和 Anthropic 相当。关于 Meta 算力策略的更详细拆解,以及具体数字,请参见我们近期的 newsletter 和 Tokenomics Model。
由 5 个泰坦集群引领的空前大规模算力爬坡
关于 Colossus 和 Elon 快速上线海量算力的能力,已有大量讨论,但 Meta 今天正在做的事情可以说更加令人印象深刻。我们的 Datacenter Industry Model 订阅者一年多前就已经知道这一点。
Meta 正在同时建设 5 个 1GW+ “泰坦”集群。它们包括俄亥俄州的 Prometheus、路易斯安那州的 Hyperion,以及位于 El Paso、Iowa 和 Indiana 的 3 个未命名园区。
人类历史上从未见过完整 1GW 园区同时在建,最接近的是 AWS 在 Indiana 为 Project Rainier 建设 800MW。然而 Meta 现在就有两个:Hyperion 和 Iowa。
在 Hyperion,Meta 正在建设全球最大的单体建筑,每栋 400MW。目前在建总规模为 1.5GW:3 座 400MW 巨型建筑,加上另外 3 座标准 100MW 建筑。
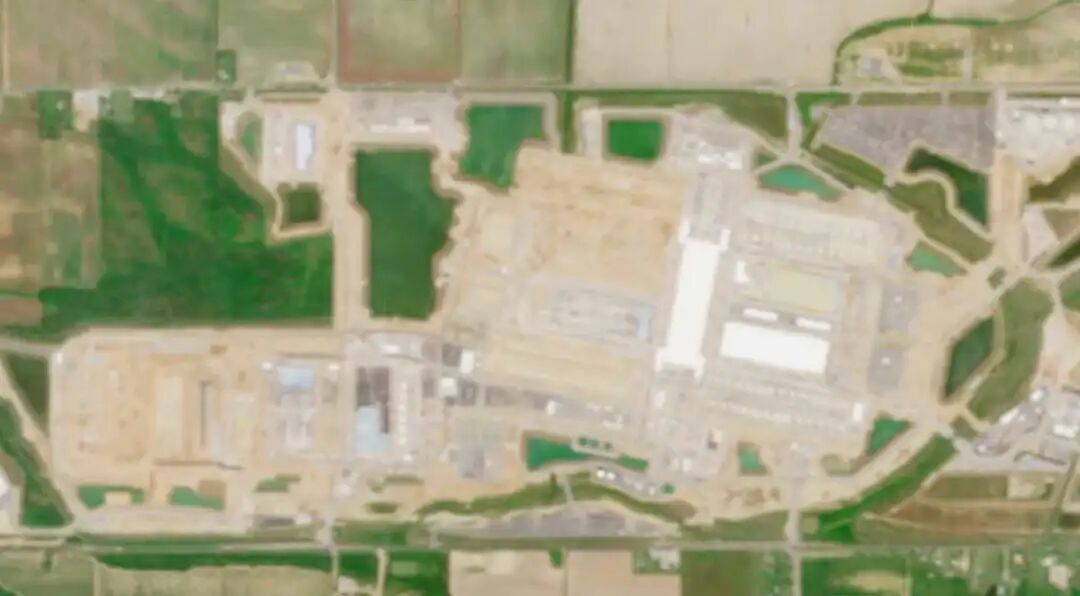
在 Iowa,Meta 与一家领先数据中心运营商签署了 1GW 租约,正如我们在 2025 年 6 月的 Datacenter Model 中提示过的那样。从下面的卫星图像可以看到,他们仅用 1 年就从零推进到完整 GW 级在建状态。
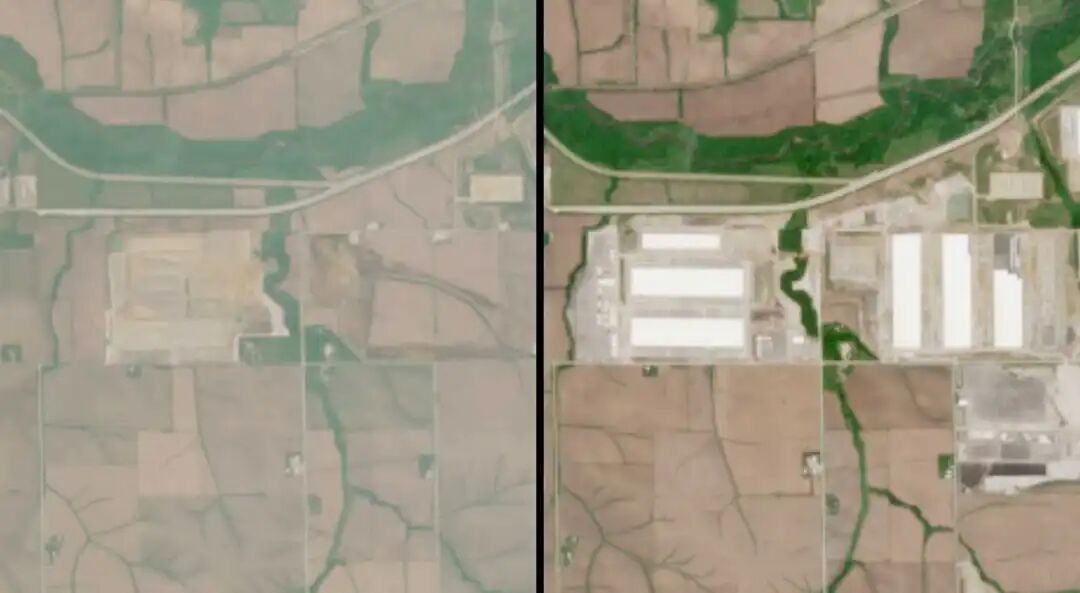
在 Prometheus,目前已经部分投入运营,Meta 当前在建规模还不到完整 1GW,但他们全面采用了我们在上一篇 MSL 文章中提到的灵活帐篷式数据中心设计。Prometheus 集群也在持续扩张,从最初约 1GW,到两年内超过 3GW。想了解 Meta 如何做到这一点,请查看我们的 Datacenter Model。我们对全部 5 个 Titans 进行建筑级跟踪,并率先用精确到月的时间线指出任何扩张。其中一些设施使用表后电力,我们跟踪具体系统类型,并标记许可风险。
连接泰坦:Meta 的跨域扩展方案
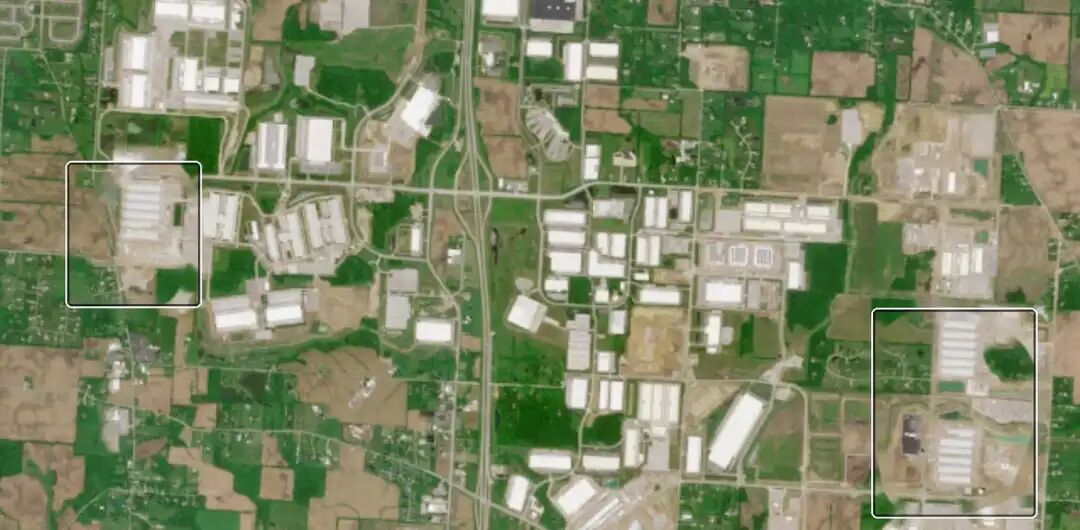
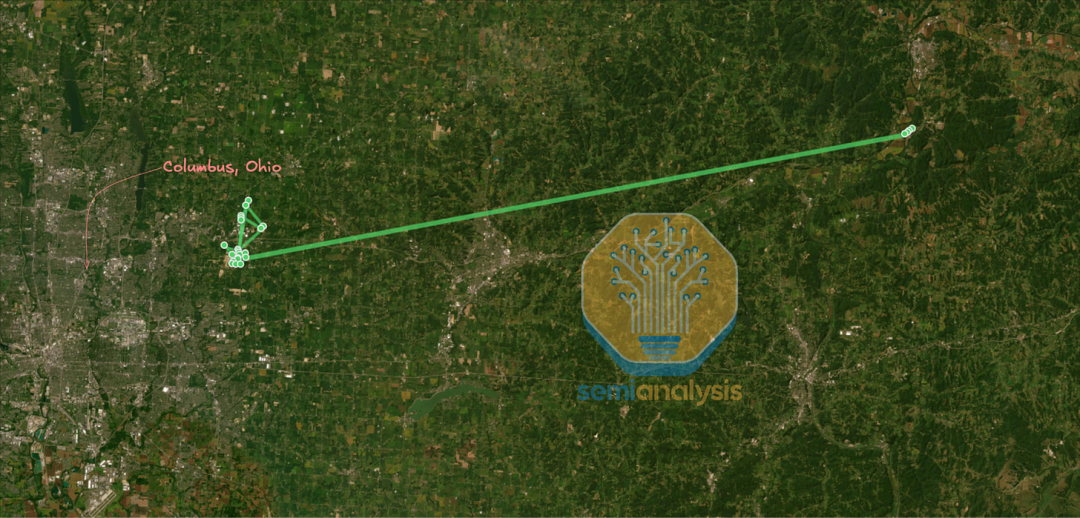
由于 Meta 主要自行建设和运营数据中心,他们有更高灵活性,可以按实际需求定制基础设施。Prometheus 就是一个很好的例子。Prometheus 由分布在 6 个园区的 27 个数据中心组成,形成一个星座。它不同于单一数据中心或单一园区。其中 5 个彼此相距 6 公里以内,第 6 个距离其余园区 75 至 80 公里。
这一设计选择背后的原因是,目前扩展到数百兆瓦非常困难,尤其是在散热和电力管理方面。训练下一代前沿 AI 模型需要大量算力,远远超过 100MW,因此把工作负载分散到多个数据中心,是突破当前限制的前进方向。
不过,这一设计选择也带来了新的挑战:网络。更大集群的全部意义在于能够在合理时间内训练更大模型。如果加速器无法高效通信,那么吉瓦级园区就没有意义。这就是 scale-across 发挥作用的地方。
为解决这一问题,Meta 推出了一种名为 AI-Backbone 的方案,简称 AIBB。这是其 10X Backbone 的演进版本,专为 AI 和超大规模集群需求设计。该网络架构由多个 L3 Superspine(简称 Backend Aggregation,BAG)组成,可互连最多 5 个 DSF(Disaggregated Scheduled Fabric)或 7 个 NSF(Non-Scheduled Fabric)横向扩展区域,这些区域也可以混合使用。随后,L3 Superspine 会汇聚到单个 L4 Inter-BAG hub,预计为整个 Prometheus 集群提供约 22 petabits/秒的双向带宽。
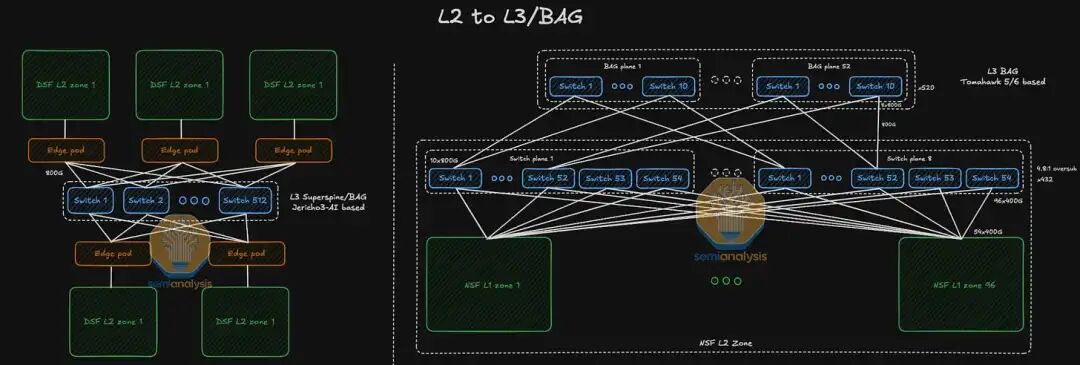
DSF 和 NSF 区域可以放入单个数据中心机房,而 L3 和 L4 分布在所有数据中心之间。L3 层位于单个园区内,L4 则主要用于连接多个园区。L3 与 L4 之间的连接混合使用 LR 光模块和搭配 ZR 光模块的密集波分复用(DWDM)系统,具体取决于通往另一园区的光纤长度。
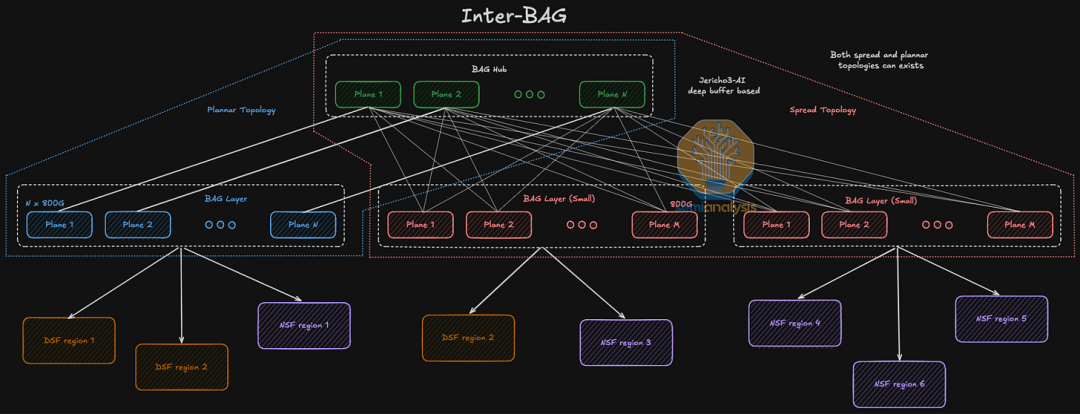
这看起来是完美方案,但该网络架构和数据中心之间的距离天然会引入延迟。在 DSF 或 NSF 区域内部,延迟通常在 1 至 10µs 之间;但到达相距 100 公里的站点,仅光在光纤中的传播就决定了延迟不可能低于 500µs,这迫使 Meta 在训练工作流中使用异步策略。预训练可以在 1 个区域内同步进行,但 RL 可以相当容易地在全球范围内分布。
Prometheus 为当前限制提供了解决方案,其他 Titans 会在 scale-across 上走得更远,连接相距最高 2000 公里的园区。
组建 MSL 超级团队
去年,Meta 因向 AI 研究人员提供足以让 Patrick Mahomes 羡慕的薪酬方案而出名。在斥资 140亿美元收购 Alexandr Wang,并另外花费 10亿美元以上买断 Nat Friedman 和 Daniel Gross 的风投基金后,有报道称,截至 2025 年 6 月底,Meta 至少挖走了 14 名研究人员。这些人大多来自 OpenAI,但也有少数来自 Anthropic 和 谷歌。一些知名人士包括 Shengjia Zhao、Trapit Bansal、Joel Pobar 和 Jack Rae。
此后,MSL 继续疯狂招聘。引人关注的研究/工程招聘包括
-
Andrew Tulloch(前 Thinking Machines 联合创始人)
-
Joshua Gross、Mark Jen、Yinghai Lu(Thinking Machines 创始团队)
-
Jason Wei、Hyung Won Chung、Zhiqing Sun(前 OpenAI)
MSL 招的不只有技术人员。今年1月,他们聘请 Dina Powell McCormick 出任总裁兼副董事长,帮助建设算力集群。她是金融圈人脉深厚的人士,也曾担任 Trump 和 W Bush 的顾问。同样在4月,他们还从 OpenAI 算力团队挖来了“三剑客”(Pete Hoeschele、Anuj Saharan、Shamez Hemani),不过其中1人已经因为 Meta 基础设施组织的文化问题离职。
这就像一支体育队突然开始大手笔砸钱买超级明星。这支新组建的 Meta 超级团队能不能真正夺冠,只能交给时间验证。不过,Zuck 已经明确表态,正在集中所有可用资源,真正冲击前沿。截至今天,其他任何 hyperscaler 都还不能这么说。根据你的先验判断,这对 Meta 的业务可能是好事,也可能是坏事,但我们认为他们最有机会追上 Anthropic/OpenAI。
但需要明确的是,成功远远没有保证。
我们整体看好 MSL 的未来,但仍需强调,他们基本还处在第1步。我们认可他们调动资源和胆识,真正尝试构建 RSI,但现在他们必须把实际工作做出来。追上 Anthropic 说起来容易做起来难。归根结底,Meta 仍是一家大型科技公司,内部有许多相互竞争的观点和优先事项。
正如我们在最近关于 Meta 算力的文章中解释的那样,Meta 短期内有很多方式可以临时将算力变现,同时保留选择权:如果其研究组织达到正确里程碑,就可以全力投入 MSL。不过,如果他们做出任何真正削弱决心的举动,例如签署没有追回条款的长期算力销售协议、解散新的 RL 任务创建组织,或放任顶尖研究员离开,那么我们会明显降低看多程度。甚至可以说,其中任何一项都等同于给 MSL 判了死刑。
我们在正式发布前短暂测试了 Muse Spark 1.1,认为它在通用 agentic 使用场景中大致相当于 Opus 4.6 或 GLM 5.2。Meta 将该模型定价略低于 GLM 5.2,这看起来是有意为之。我们的一些工程师注意到,它有个坏习惯:会忽略警告,而不是修复警告,并且不能正确使用编辑工具。
我们内部的 token 用量不会转向 Muse Spark 1.1,但在这个阶段这仍属预期之内。即使在乐观情境下,我们也不预计他们会在今年年底前达到 Anthropic 或 OpenAI 的水平。
这对 谷歌 意味着什么
将3000名工程师重新分配到全职 RL 任务创建、快速扩张多 GW 级内部算力,以及向顶尖人才发放10亿美元级股权激励,这些都是强有力的证据,说明 Meta 真的已经“AGI-pilled”。尽管遭遇重大负面公关、内部反弹,以及股价严重受挫,他们仍愿意跳出常规思维,利用自身相对于 Anthropic/OpenAI 的所有优势。
Alexandr Wang 在最近一次播客中说得很好。每一家真正的前沿实验室,起点都是一个核心信念:超级智能即将到来,未来所有商业决策都必须服从这一根本信念。
历史上,这种必要的宗教般狂热只存在于初创公司,也就是 OpenAI 和 Anthropic 这类以构建数字神明为明确目标创立的公司。谷歌 或许口头上支持超级智能这个理念,但很明显,许多关键高管并不真正相信“数据中心里的天才之国”会在未来3年内出现。如果他们相信,就会把所有算力都导向 DeepMind,而不是主动扶持 DeepMind 最强的竞争对手。
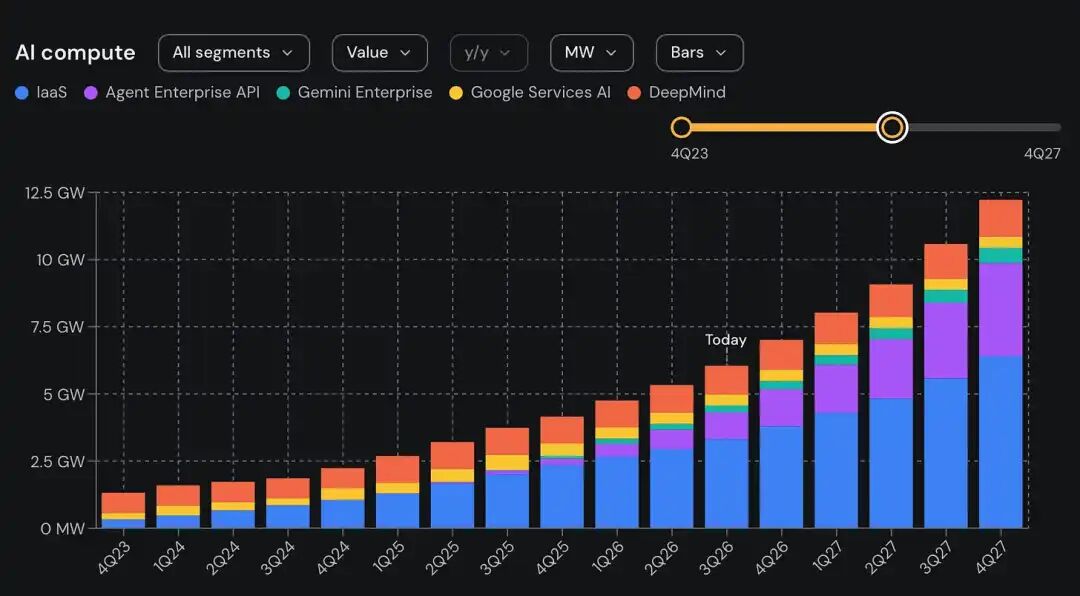
我们预计,未来2年 谷歌 大部分新增数据中心容量将流向基础设施即服务(IaaS)和第三方 API 业务。DeepMind 的训练算力将少于 OpenAI、Anthropic 和 MSL。是的,他们刚刚发行了850亿美元股权,用于建设更多 AI 基础设施,但我们认为,这些新增算力中的大部分将租给 Anthropic 等客户。
这是 谷歌 的输家心态。
谷歌 最近还失去了更多优秀 RL 人才,他们去了 Anthropic。谷歌 的 RL 工作过于分散。如果 谷歌 真的认真想触达前沿,就应该立即让一部分软件工程师去做 RL 任务,并将显著更多算力重新分配给 DeepMind。我们也给 微软 AI 和 Amazon AGI 同样的建议,但它们已经无可挽回。
在我们看来,当前第3名之争是在 Meta 和 SpaceX 之间,而不是 谷歌。
免责声明:文章中的所有内容仅代表作者的观点,与本平台无关。用户不应以本文作为投资决策的参考。
你也可能喜欢
微软大涨,市场终于想明白了什么?
9月24日美市更新支撑阻力:18品种支撑阻力(金银铂钯原油天然气铜及十大货币对)
Dropbox盘前跌逾3%
美元涨、美债收益率涨、油价还可能涨,白银三面承压,50日均线撑得住吗?
加密货币价格
更多


