
AI纵向扩展网络深度:大摩继续上调,1,152颗GPU、6米铜互连与2029年共封装光学

1.730亿美元市场来自规模与带宽的双重放大。 摩根士丹利把2030年纵向扩展网络市场上调至约730亿美元,较此前对2029年的170亿美元估计扩大约4倍,2026—2030年复合增速约46%。驱动力既有AI资本开支上修,也有单个纵向扩展域从72颗GPU走向576颗、1,152颗GPU后,每颗加速器所需交换带宽和互连端口同步增加。
2.铜互连至少还能守住未来2年。 无源铜缆在短距离内仍具备最低时延、最低功耗和最低成本,448G串行器/解串器、PAM6调制及200G重定时器有望把可用距离延伸至约6米。Rubin Ultra更可能采用机架内铜、机架间光的混合结构,铜的份额会下降,却不会在下一代机柜中突然消失。
3.2029年才是共封装光学的关键验证年。 2028年纵向扩展网络中的共封装光学渗透仍可能只有低个位数,Feynman把单域扩大至1,152颗GPU后,跨机架带宽密度与输入输出功耗才更有机会压过成本、良率、维修和供应链锁定等阻力。完整3D共封装结构更可能留到2030年以后。
4.协议选择决定利润池落到谁手里。 英伟达依靠NVLink和NVSwitch维持封闭系统优势;博通以纵向扩展以太网和定制加速器覆盖开放生态;PCIe仍是2026—2027年的过渡桥梁;UALink则是2027年以后的最大变量。云厂商不会采用单一路径,协议转换、重定时、交换芯片和测试测量因此都能获得增量价值。
5.近期顺序偏向连接芯片,远期才轮到光学弹性。 2026—2027年更直接的受益者是英伟达、博通、Astera Labs、Semtech、Credo和迈威尔科技;2028年以后,康宁、Lumentum、Coherent及是德科技的光纤阵列、激光器、光引擎、光路交换和测试需求开始放大。产业方向正确仍需匹配盈利兑现和估值,光学公司的中心情景并未全面高于市场共识。
6.4个反证会推迟光化交易。 铜传输距离继续突破、纵向扩展域停留在单机架、推理工作负载不需要超大共享域、共封装光学的故障率和维护成本迟迟降不下来,都会把收入拐点向后推。后续应盯住Rubin Ultra真实机架结构、200G每通道铜缆距离、首批纵向扩展光引擎订单以及Feynman是否维持1,152颗GPU设计。
目录加入知识星球,可以查看完整原文报告以及参考研报原文
- 一、730亿美元重估:网络价值量开始追赶算力扩张
- 二、数据移动落后于计算:为什么瓶颈转向纵向扩展网络
- 三、6米铜互连:短期主线是延寿,不是退出
- 四、Rubin Ultra到Feynman:光先进入机架之间
- 五、5套协议并存:开放生态仍未选出统一标准
- 六、利润池排序:2026—2027年看芯片,2028年后看光学
- 七、光学受益顺序:架构无关资产优先
- 八、
- 九、
- 十、
- 十一、
AI集群继续变大,网络的约束已经从跨机房吞吐下沉到机架内部与机架之间的数据移动。未来3年的投资顺序不会简单地从铜切到光:2026—2027年先看铜互连延寿和协议分化,2028年看混合铜光,2029年再验证共封装光学能否真正放量。
一、730亿美元重估:网络价值量开始追赶算力扩张
纵向扩展网络正在从机柜配件变成AI系统的主设备。 过去市场更习惯按GPU数量外推服务器价值,网络只被当作随算力同比增长的附属项。新一代系统改变了这个关系:加速器数量增加、每颗加速器带宽上升、交换层级变多,网络价值量会以高于GPU数量的速度增长。
摩根士丹利最新估计,2030年纵向扩展网络市场约730亿美元,较此前对2029年的170亿美元预测扩大约4倍,2026—2030年复合增速约46%。这个口径还没有纳入网卡、可插拔光模块和线缆,因此更接近交换与互连底座,而非整个AI网络产业链的总收入。
市场扩容包含3个乘数。 第1个乘数是AI资本开支。云厂商和模型公司提高集群预算,带来更多加速器。第2个乘数是纵向扩展域变大,单个任务可以同时调用更多GPU。第3个乘数是单颗GPU的带宽提高,交换芯片、串行器/解串器、重定时器、线缆和光引擎随端口数与速率一起增加。
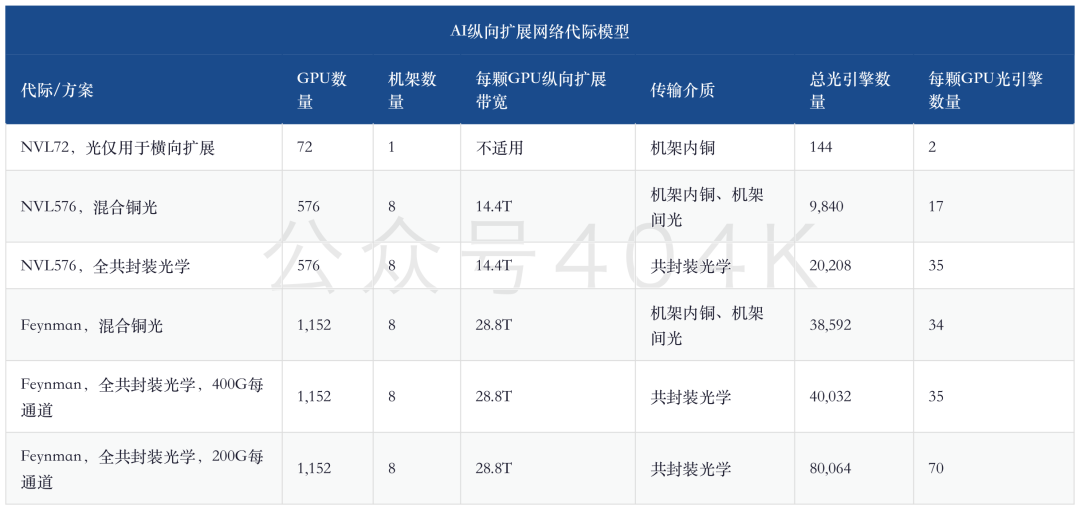
这张表给出最重要的数量级:从NVL72到Feynman,GPU数量扩大16倍,每颗GPU的光引擎含量可能从2个增加到34—70个。最终采用混合方案还是全光方案仍有争议,但网络内容价值上升已经不依赖单一技术路线。
二、数据移动落后于计算:为什么瓶颈转向纵向扩展网络
计算性能和互连性能的长期剪刀差正在扩大。 报告统计,硬件浮点性能过去30年提高约600万倍,平均每2年提高约3倍;互连带宽在23年内只提高约450倍,平均每2年提高约1.6倍。算力增长越快,等待通信、同步和内存访问的时间就越贵。
大模型训练尤其放大这个矛盾。张量并行、流水线并行、专家并行都会在单次迭代中制造大量加速器间通信。模型进入混合专家结构后,不同GPU之间的全对全数据交换增加,网络拥塞会直接降低昂贵加速器的利用率。节省1瓦输入输出功耗、缩短1次同步等待,都会在数万颗加速器的集群中转化为可观的电力和折旧价值。
纵向扩展和横向扩展承担不同任务。 纵向扩展网络连接同一个高性能计算域内的GPU,追求低时延、内存语义和高可靠性;横向扩展网络连接多个服务器、机架或集群,强调通用性、路由能力和可管理性。两者边界会随着系统扩大而移动:当一个纵向扩展域从单机架延伸到8个机架,原来属于横向扩展的距离问题就进入纵向扩展设计。
这也是Rubin Ultra的重要性。576颗GPU、8个机架意味着机架内仍可优先使用铜,机架之间必须处理更长距离、更高端口密度和更大的输入输出功耗。Feynman再把域扩大到1,152颗GPU,光互连获得的节能和密度收益会进一步放大。
Copper interconnects remain the preferred medium for short-reach connectivity because they provide the lowest latency, lowest power consumption and lowest cost. However, as signalling speeds increase, electrical losses, insertion loss and noise become progressively more difficult to manage, requiring increasingly sophisticated SerDes, digital signal processors, retimers and equalization techniques simply to preserve signal integrity. This phenomenon is often referred to as the industry’s “copper wall.”
这段判断给出了技术选择的起点:只要距离和损耗允许,系统设计者仍会优先用铜;光只有在带宽密度、传输距离和功耗收益足以覆盖额外复杂度时才进入。
三、6米铜互连:短期主线是延寿,不是退出
铜的经济性仍然很强。 无源直连铜缆不需要光电转换,时延、功耗和成本均低于光模块。机架内部距离短、布线可控、维修方便,这些条件让铜继续成为下一代AI机柜的默认选择。
铜的物理损耗会随速率提高而恶化,产业链正在用更强的串行器/解串器、均衡、重定时和调制方式换取距离。448G串行器/解串器、PAM6调制和200G重定时器有望把高速连接延伸到约6米。这个距离足以覆盖多数机架内部链路,也能触及部分相邻机架连接。
铜互连会分成3个层次。 无源直连铜缆适合最短距离;有源铜缆(ACC)通过模拟重驱动把距离延伸到约3米,同时保留较低功耗;有源电缆(AEC)加入重定时、均衡和时钟恢复,常见距离可达7—9米,但在200G每通道下可能压缩到约5米。AEC功耗仍可比可插拔光模块低约50%。
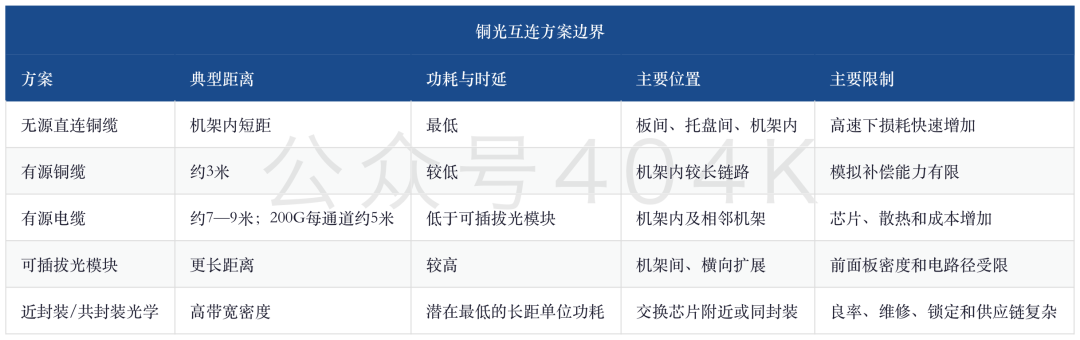
投资节奏因此更接近“铜先兑现,光后接力”。Astera Labs、Credo、Semtech和迈威尔科技可从重定时、协议转换、AEC及高速串行器/解串器中获得近期收入。缺少光学路线的单一铜供应商会在2029年以后面对增长天花板,但2026—2027年的订单不应因远期光化而被提前否定。
四、Rubin Ultra到Feynman:光先进入机架之间
Rubin Ultra更可能采用混合铜光。 机架内部使用铜可以保留成本、功耗和时延优势,机架之间使用光可以跨越距离和密度瓶颈。这个结构使光含量明显提高,同时避免把整套系统一次性押在尚未成熟的共封装工艺上。
共封装光学(CPO)把交换芯片到前面板光模块之间约15—30厘米的电路径压缩到数毫米,减少高速电信号在印刷电路板上的损耗。报告估计,光互连相关功耗可能下降约50%—80%。当带宽、端口数和机架数量同时增加,这部分节能会从单个器件优势变成数据中心电力优势。
2028年仍是试用期。 报告预计纵向扩展网络的共封装光学在2028年只有小规模采用,2029年以后才明显提高。Feynman计划把单域扩大到1,152颗GPU,更高的跨机架流量和每颗GPU 28.8T带宽为共封装光学提供更明确的经济账。完整3D共封装结构的制造难度更高,规模化时间更可能在2030年以后。
近封装光学(NPO)会成为重要过渡。光引擎靠近交换芯片,却不与芯片完全封装在一起,可以保留开放性、可插拔性和维修便利。对于不愿把激光器、硅光、封装和交换芯片全部交给单一供应商的客户,近封装方案能用部分能效换取供应链弹性。
光路交换(OCS)提供另一条路径。它在光域直接切换连接,适合流量模式相对稳定的训练任务和大批量数据传输。微机电系统方案成熟度最高、插损较低、切换快;硅基液晶方案寿命更长但速度较慢。谷歌采用光路交换与环面拓扑,说明超大纵向扩展域并不必然等于传统交换芯片加共封装光学。
五、5套协议并存:开放生态仍未选出统一标准
网络协议将决定芯片份额和供应链开放程度。 英伟达的NVLink拥有更高带宽、更低时延和完整软件协同,代价是系统更封闭。NVLink Fusion允许第三方中央处理器、加速器和定制芯片接入NVLink,既扩大生态,也把协议转换和互连控制权继续留在英伟达体系内。
PCIe在2026—2027年仍是非英伟达纵向扩展网络最现实的桥梁。它的性能不及专用内存语义互连,却有成熟生态、广泛兼容性和可用芯片。Astera Labs的Scorpio-P和Scorpio-X正好承接这段过渡期。
UALink代表开放内存语义互连的最大变量。商业交换芯片和大规模部署预计要到2027年以后,成员能否按时交付、软件栈能否稳定、云厂商是否愿意形成共同标准,都会影响Astera Labs和迈威尔科技的收入斜率。
以太网纵向扩展方案依靠博通Tomahawk等交换芯片,把开放、成熟供应链和规模经济带入机架内部。它在极低时延与内存语义上仍需增强,但云厂商可以用软件、网卡和自研加速器协同补足。亚马逊云科技(AWS)的随机网络生成拓扑把路由器数量减少69%、吞吐量提高最多33%、网络设备电耗降低约40%,说明拓扑创新也能改变硬件需求。
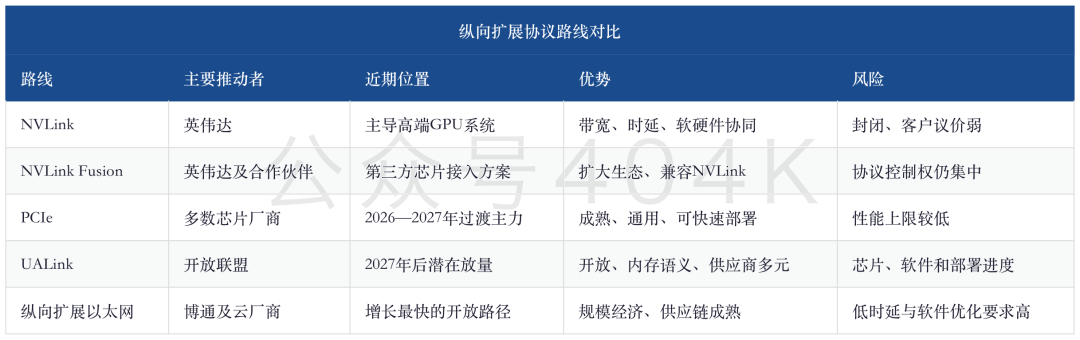
Whether this ultimately proves advantageous as AI clusters continue to scale remains an important question. The non-英伟达 ecosystem remains largely undecided. Over the next two years, architectural decisions made by hyperscalers and ASIC customers will determine which fabrics emerge as industry standards, creating a significant greenfield opportunity for Broadcom, 迈威尔科技 and Astera Labs.
协议尚未收敛会增加研发成本,却利好跨架构器件。重定时器、协议转换芯片、测试仪器、光纤阵列和激光器可以服务多套系统,不必准确押中最后的网络标准。
六、利润池排序:2026—2027年看芯片,2028年后看光学
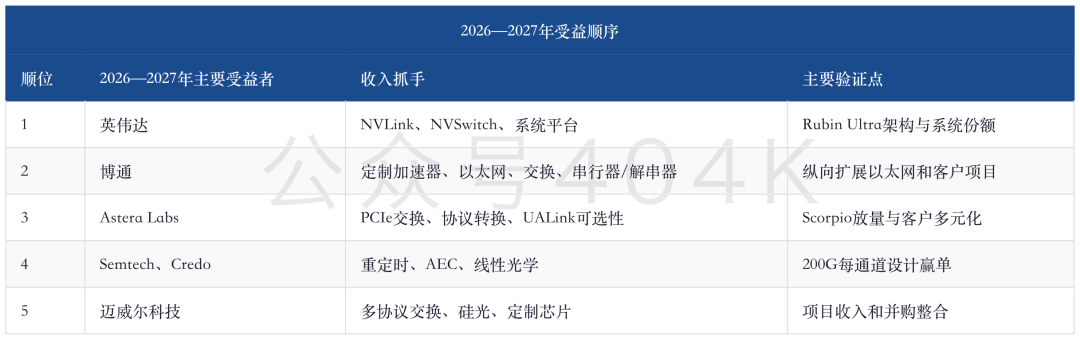
英伟达仍是系统利润池的第一顺位。 NVLink、NVSwitch、GPU和系统平台共同形成端到端控制,网络价值量上升会直接进入整机内容。风险来自定制加速器份额增加,以及客户用开放协议降低供应商集中度。
博通(AVGO)拥有最完整的开放生态组合。 定制加速器、Tomahawk交换芯片、串行器/解串器、以太网、PCIe、网卡和光学能力可以组成整套方案。即使共封装光学推迟,博通仍能从铜、交换和定制芯片获得收入;若以太网纵向扩展胜出,内容价值还会继续提高。
Astera Labs是近期弹性最大的纯连接标的。 公司上市时每颗加速器内容价值约50—100美元,目前已提高到1,000美元以上,Scorpio-X开始出货后,投资者会进一步关注UALink采用和客户多元化。风险是估值较高、客户集中,以及开放协议放量慢于预期。
Semtech与Credo同时站在铜延寿和光化两侧。 Semtech的CopperEdge受益于铜连接,FiberEdge、DirectEdge和HieFo覆盖线性光学、1.6T、3.2T及近封装/共封装场景。Credo依靠AEC获得近期收入,并向纵向扩展交换和光学器件延伸;管理层预计2027财年收入增长超过80%,光学产品收入超过6亿美元。新品过多、执行复杂度提高,是两家公司共同风险。
迈威尔科技覆盖面广,兑现节奏最需要验证。 公司参与UALink、以太网纵向扩展和NVLink Fusion,也通过并购补充光互连和硅光能力。它能从多条路线中获益,投资难点在于客户项目何时转成可见收入,以及整合成本会不会抵消增长。
七、光学受益顺序:架构无关资产优先
康宁的优势是无源光学不押协议。 光纤阵列、保偏光纤、外置激光光纤和GlassBridge可以用于2D共封装、2.5D共封装及近封装结构。系统采用NVLink、UALink或以太网,光纤连接仍然存在,因而康宁的架构依赖相对较低。
Lumentum的弹性集中在激光器、光引擎和光路交换。 高功率连续波激光器为共封装光学提供光源,微机电系统光路交换又对应超大集群的拓扑变化。公司预计纵向扩展光学产品在2027年底出货、2028年初进入市场,首批机会可能达到早期横向扩展共封装项目的3—4倍。电吸收调制激光器供给、毛利率和放量时间决定盈利兑现。
Coherent覆盖链条更长。 激光器、外置激光模块、光纤阵列、保偏光纤、隔离器、热电制冷和硅基液晶光路交换都能进入纵向扩展系统。覆盖面提高单个系统的内容价值,也增加产能、定价、债务和制造执行风险。
是德科技是架构分散的受益者。 客户正从800G量产转向1.6T研发,并开始规划3.2T;多套协议、更多速率和更复杂封装需要反复进行物理层、协议层和系统级测试。超过一半收入来自研发和实验室场景,使其更早看到技术路线变化。
Bottom line, customers are ramping 800G, accelerating 1.6T R&D, and already planning for 3.2T, while also optimizing for speed, power, density, scale-up networking, and scale-out architectures. We believe this concurrency matters because it raises test intensity, broadens the number of customer programs 是德科技 can serve, and reduces reliance on any single product cycle. Faster innovation cadence and greater system complexity should support a longer growth runway than investors typically assign to test and measurement.
这组受益顺序有一个共同点:越接近架构无关的光纤、激光和测试环节,越不需要押中某一套协议;越接近光引擎、交换平台和先进封装,单位价值越高,路线与客户风险也越大。
剩余30%章节可以加入知识星球查看,完整原文以及参考报告原文已经发知识星球,欢迎加入
免责声明:文章中的所有内容仅代表作者的观点,与本平台无关。用户不应以本文作为投资决策的参考。
你也可能喜欢
加息概率飙至64.2%,ETF却狂吸23.8亿!你站哪边?(09月27日)
Lighter 已确认,交易积分值得跟踪
高盛谈加息:市场押得太狠?美联储或只需再加一次息
经济学家:CPI存在先天缺陷,道指黄金比才是真实通胀标尺

加密货币价格
更多


